ASTRA × NOVA SEMI · COMPUTATIONAL PROCESS STUDY
평균은 가까워졌다.
균일도는 남았다.
단일 blanket SiO₂ · silica slurry CMP의 공급·패드 변동을 다룬 교육용 연구. 복잡한 AI의 우월성 대신, 예측과 제어가 실제로 개선한 것과 해결하지 못한 것을 분리합니다.
summary.json 결과를 불러오는 중입니다.
01 / PROBLEM
무엇을 제어하고, 무엇을 가정했는가
장비 변경 없이, 압력과 정지 시점
공정 전 3개 구역 압력을 각각 2.0 / 2.5 / 3.0 psi 중 선택합니다. 27개 조합에서 예측 9지점 두께와 목표의 평균 제곱 오차를 최소화하고, 40–100초 범위의 정지 시점(stop-in)을 다룹니다.
엔드포인트 정책은 2초 간격의 지연·잡음 신호를 예측 제거율로 보정합니다. 신호 지연 3초, 잡음 2.0 nm도 교육용 가정입니다.
합격은 평균만으로 결정하지 않는다
9개 평가 지점 각각이 485–515 nm에 들고, 최대–최소 두께가 30 nm 이하여야 공동 합격입니다. 평균 목표 오차, 공간 범위, 공동 합격률을 별도로 보고합니다.
대상은 단일 blanket SiO₂와 silica slurry입니다. 패턴 dishing, STI stop-on, 조성 최적화, 이미지 분류는 제외합니다. 수치 한계·응답 계수·사건 빈도는 기업 레시피나 문헌 피팅값이 아닙니다.
02 / PRIOR ART
현실의 접근을 참고하되, 산업 기준선을 자칭하지 않는다
APC / MICO
공개 CMP 제어 사례를 통해 공정 변동과 피드백의 맥락을 설정했습니다.
공개 자료 읽기 ↗Endpoint control
종료 신호가 공정 중 새로운 정보를 제공한다는 비교의 근거입니다.
공개 자료 읽기 ↗VM / Run-to-run
가상 계측과 R2R 제어의 기존 접근을 참고했습니다.
논문 DOI ↗역사적 공개 자료이지 현재 내부 운영에 대한 설명이 아닙니다. 본 연구의 고정 조건 기준선은 산업 APC를 대표하지 않습니다.
03 / METHOD
AI가 한 일과 검증 데이터의 경계
생성·예측 코드를 작성한 Astra
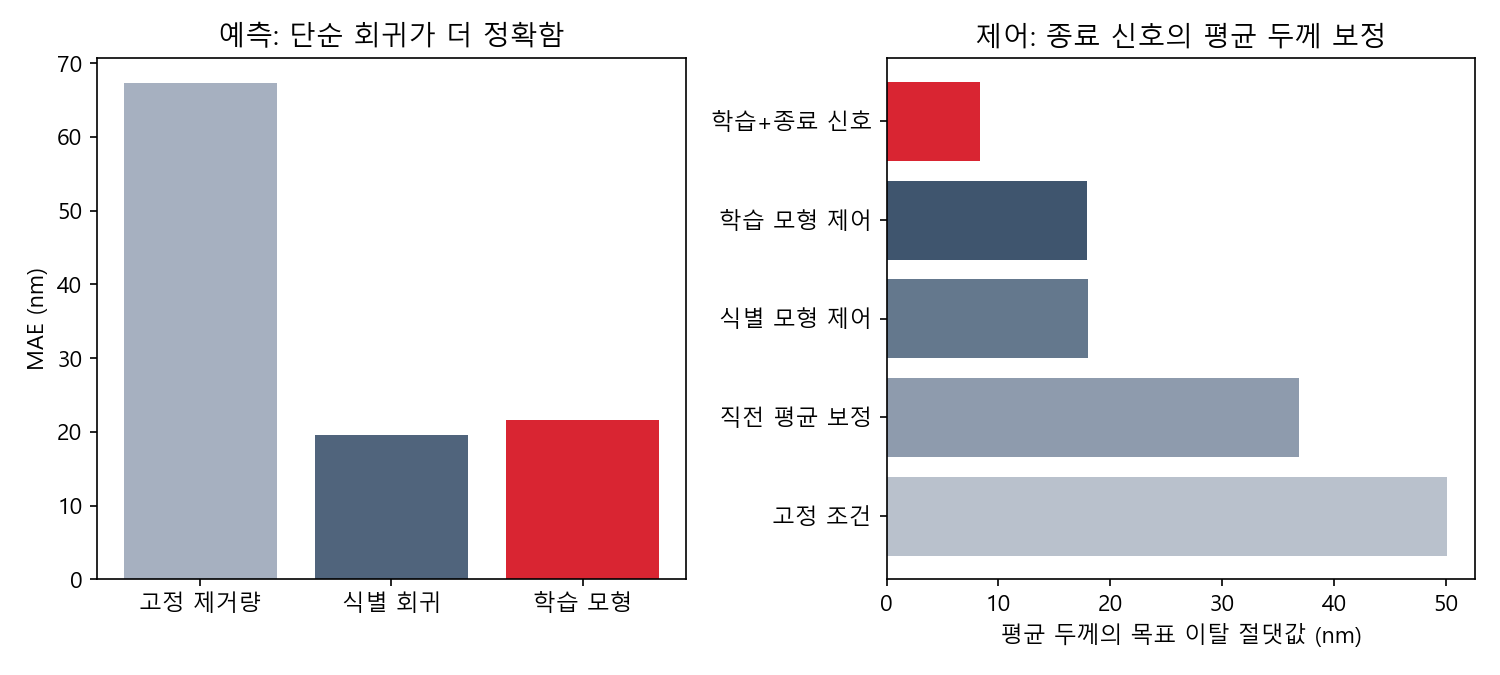
Astra가 생성기와 모델 코드를 작성하고, 로컬 NumPy / scikit-learn으로 학습·평가했습니다. 복잡한 후보 중 검증 MAE로 HistGradientBoosting을 선택했으나, 전체 비교에서는 단순 Ridge가 더 좋았습니다.
에이전트는 제한된 네이티브 함수 호출로 검증 사례를 읽고, Astra가 고른 추가 점검 하나를 요청한 뒤 계획과 근거 보고서를 생성합니다. 기존 TF-IDF 검색은 의미 임베딩이나 웹 챗봇이 아닙니다.
관측 라벨과 숨겨진 정답을 분리
학습 라벨은 공정 후 잡음 계측(1.2 nm)만 사용합니다. 숨겨진 평가 정답은 성능 산출용이며 학습·계획 입력이 아닙니다.
배치 0–71 / 72–95 / 96–119를 학습 / 검증 / 테스트로 분리했습니다. 테스트 배치 절반에는 사전 선언된 추가 평활 상호작용을 넣고 nominal / stress를 따로 확인합니다. 기존 테스트를 보고 재조정하지 않았습니다.
04 / OFFLINE VERIFICATION
60초 잔여 두께 예측
MAE·RMSE는 nm, R²는 무차원입니다. 낮은 오차가 좋고 R²는 높을수록 좋습니다. Ridge는 식별 회귀, Hist는 선택된 복잡 모델입니다.
결과 대기
검증 성능과 선택 근거
Hist 선택은 복잡 후보군 내 선택입니다. Ridge보다 우월하다는 의미가 아니며 테스트 성능으로 모델을 다시 선택하지 않았습니다.
정답 대 예측 · 선택 모델 전용
선택 모델의 사건·스트레스·지점·제거량 진단
False는 nominal, True는 사전 선언 stress입니다. 부분집합 점수는 독립적 새 테스트나 인과적 효과의 증명이 아닙니다.
05 / CLOSED-LOOP COMPARISON
평균 오차 감소 ≠ 공간 품질 확보
결과 대기
개선과 악화를 함께 읽기
평균 목표 오차와 프로파일 범위 비교 대기
엔드포인트에는 새로운 공정 중 관측 정보가 추가됩니다. 이 차이는 순수 모델 개선 효과가 아닙니다. 공동 합격률이 낮아 품질 목표를 확보했다고 결론낼 수 없습니다.
사례별 9지점 프로파일
테스트 첫 12개 배치의 첫 웨이퍼를 결과와 무관하게 수록했습니다. 성공 사례 선별이 아닙니다.
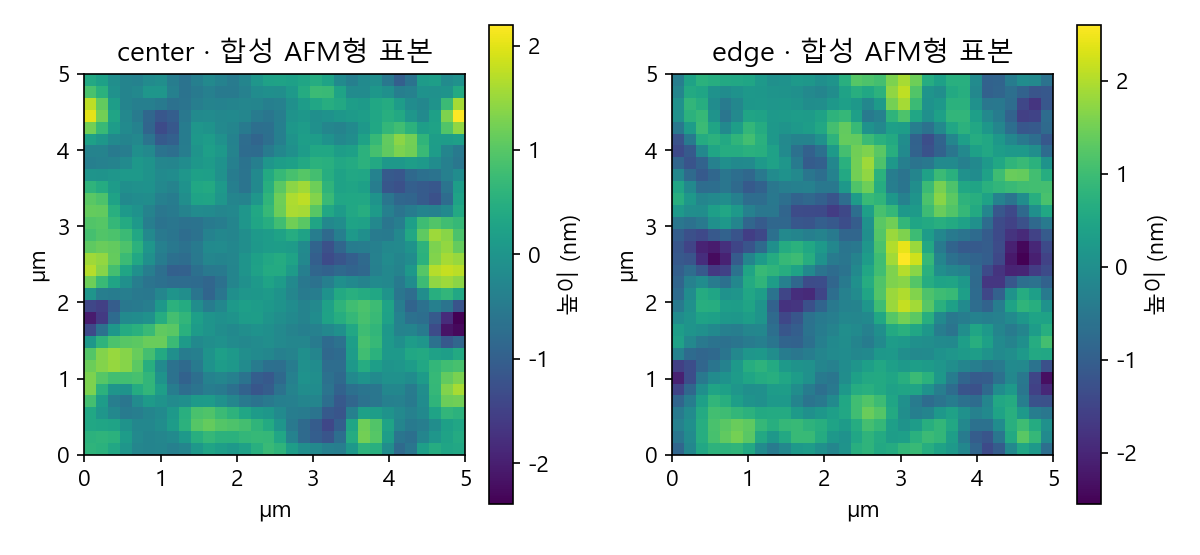
AFM은 매 12번째 웨이퍼의 중심·가장자리 패치이며 공정 후 120초에 이용 가능합니다. 현재 웨이퍼 정지 제어의 선행 관측으로 사용하지 않습니다.
06 / BOUNDED AGENT
저장된 실제 API 실행 사례, 실시간 챗봇 아님
실제 native 호출은 get_case → request_check(추가 확인 1회) → compute_plan이며, 그 뒤 보고를 생성했습니다. Astra가 pad_reference를 선택했고 TF-IDF 검색은 로컬 도구 내부에서 수행했습니다. 최초 보고의 단위 오류를 psi로 정정하고 v2 근거로 검색 범위를 제한했습니다. 장비 변경이나 미관측 테스트 조정은 없습니다.
계획과 근거
대기 · 저장된 보고서가 아직 없습니다.
실행 검증
대기 · 실행 검증 결과가 아직 없습니다.
추적 기록·타임스탬프·점검 예산·근거·수치 일관성의 제한적 사례 확인입니다. 일반적 에이전트 우월성, 실제 공정 안전성 또는 생산 품질을 증명하지 않습니다. API 비용은 성능 지표가 아닙니다.
07 / FINDINGS & LIMITS
더 복잡한 AI보다,
더 필요한 공간 관측.
확인한 것
Ridge의 전체 예측 성능이 복잡 모델보다 좋았습니다. 평균 목표 오차는 줄었지만 공간 범위는 악화했고 공동 품질 목표는 충족하지 못했습니다.
다음 검증의 조건
새로운 공간 관측과 공간 목적함수 설계를 사전 등록하고, 독립적인 새 테스트에서 검증해야 합니다. 현재 테스트의 재튜닝은 하지 않습니다. 실제 팹·수율·원가 절감으로 외삽하지 않습니다.
08 / OPEN DELIVERABLES